Lightricks의 LTX-2.5는 비디오와 동기화된 오디오를 생성하는 대규모 생성 모델이며, ltx-pipelines는 이 모델의 가중치를 불러와 텍스트나 이미지로부터 비디오를 추론하고 파일로 출력해 주는 공식 실행 프레임워크입니다. LTX-2.5는 이전 세대와 달리 전체 모델을 하나의 파일로 묶지 않고 트랜스포머, 텍스트 인코더, VAE, 업샘플러 등 역할별 safetensors 파일로 분할하여 배포합니다.
분할 가중치 배포 방식은 효율적인 컴포넌트 교체와 생태계 호환성을 제공하지만, 처음 설치하는 개발자에게는 여러 경로를 개별 지정해야 하는 혼선과 Hugging Face 게이트 라이선스로 인한 401/403 인증 실패를 유발하기 쉽습니다. 이 가이드에서는 LTX-2 공식 저장소 환경 구축부터 인증 오류 해결, 모델 다운로드, ltx_pipelines.distilled CLI를 통한 첫 비디오 생성 절차까지 순서대로 설명합니다.
LTX-2.5 아키텍처와 분할 가중치 구조의 이해
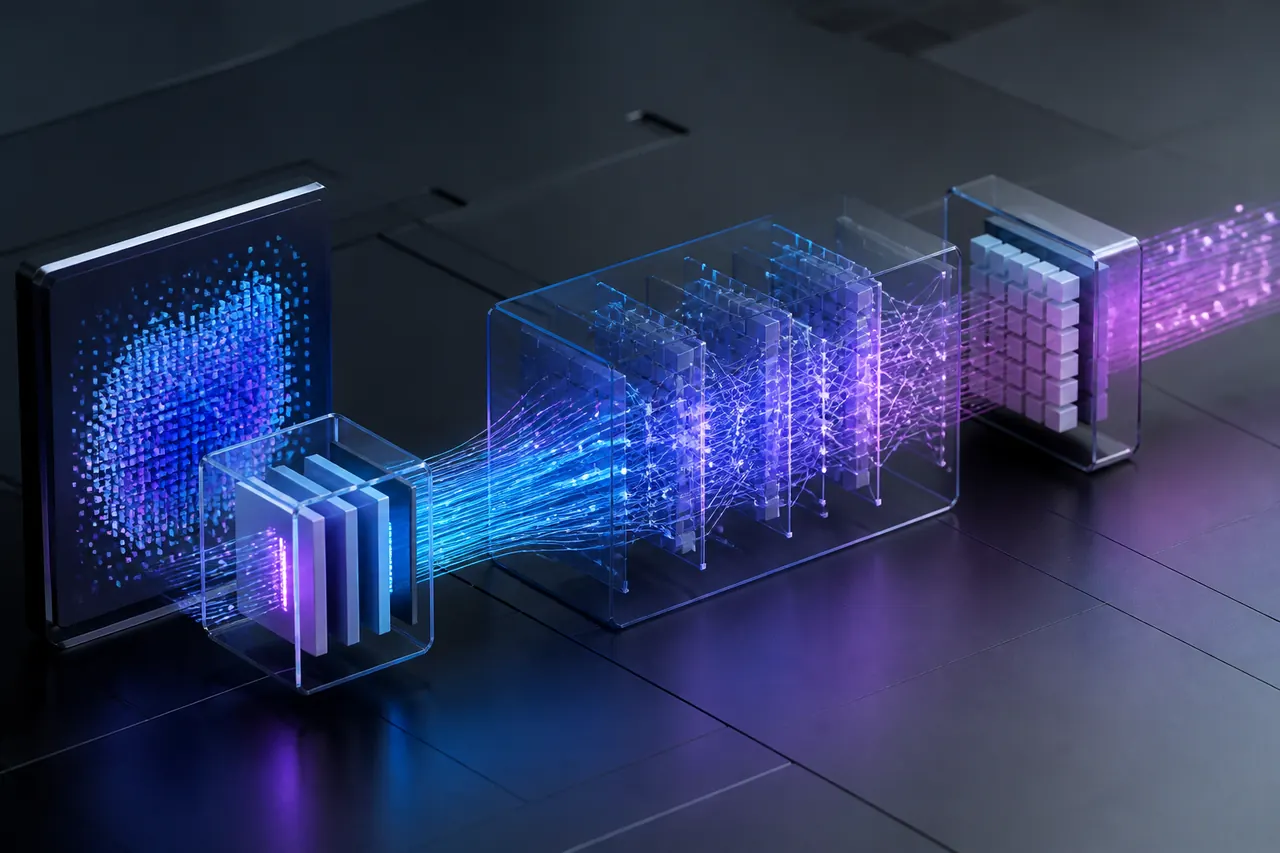
LTX-2.5 파이프라인을 다룰 때 가장 먼저 파악해야 할 점은 모델 컴포넌트의 구성 방식입니다. LTX-2.3과 같은 이전 체크포인트는 트랜스포머, VAE, 텍스트 프로젝션이 단일 파일로 묶여 있고 텍스트 인코더만 분리되어 있었으나, LTX-2.5는 모든 핵심 부품이 개별 safetensors 파일로 분리되어 있습니다. 이는 ComfyUI 생태계와의 구조적 정렬 및 개별 모듈 최적화를 지원하기 위한 설계입니다.
LTX-2.5 추론 파이프라인이 정상적으로 동작하기 위해서는 다음과 같은 컴포넌트들이 지정된 디렉터리에 정확히 준비되어야 합니다.
- 트랜스포머 (Diffusion Transformer): 핵심 확산 연산을 담당하며, 고속 처리를 위해 증류된(distilled) 22B 파라미터 기반 가중치(ltx-2.5-22b-distilled-transformer-bf16.safetensors)가 사용됩니다.
- 텍스트 인코더 (Text Encoder): 입력 프롬프트 문맥을 파악하는 언어 모델 가중치로, Gemma 4 기반 프로젝션 통합 파일(gemma4-12b-with-proj-ltx-2.5-bf16.safetensors)을 로드합니다.
- 비디오 및 오디오 VAE (Video/Audio VAE): 생성된 잠재 표현(latent)을 실제 픽셀 영상과 음향 신호로 디코딩하는 모듈입니다.
- 잠재 공간 업샘플러 (Latent Spatial Upscaler): 2단계 파이프라인에서 해상도와 세부 묘사를 증폭시키는 2배율 공간 업스케일 가중치입니다.
- 선택적 추가 모듈: 영상 재생 길이를 프롬프트로부터 자동 예측하는 Duration Head 모듈이나 품질 강화를 위한 DFR(Detail-Fidelity Rendering) 전용 LoRA 등이 있습니다.
이러한 모듈들이 개별 파일로 분할되어 있기 때문에 추론 CLI를 구동할 때 각각의 파일 경로를 명시적인 플래그로 전달해야 합니다.
실행 환경 구성: 사양 요구사항과 uv 패키지 동기화
LTX-2.5 모델 파이프라인을 안정적으로 로드하고 실행하려면 권장 하드웨어 및 소프트웨어 사양을 충족해야 합니다. 공식 저장소 문서에서 명시하는 권장 실행 사양은 다음과 같습니다.
- Python 런타임: Python 3.12 이상
- CUDA 툴킷: CUDA 12.7 이상
- PyTorch 버전: PyTorch 약 2.7 (PyTorch ~= 2.7)
패키지 및 가상환경 관리는 고속 Python 패키지 관리자인 uv를 기본 도구로 사용합니다. 공식 LTX-2 저장소를 복제한 후, 비디오 VAE 디코딩 연산을 가속하기 위한 엑스트라 의존성을 포함해 동기화를 진행합니다.
# 저장소 복제 및 이동
git clone https://github.com/Lightricks/LTX-2.git
cd LTX-2

# 의존성 설치 및 가상환경 동기화
uv sync --extra natten
여기서 --extra natten 플래그는 확산 비디오 VAE 가속을 위한 Neighborhood Attention 백엔드 패키지를 함께 설치하도록 지시합니다. 이 옵션의 플랫폼별 동작 특성은 다음과 같습니다.
- Linux + CUDA 환경: natten 가속 백엔드가 정상 빌드 및 활성화되어 가장 빠른 디코딩 속도를 제공합니다.
- Windows 및 macOS 환경: natten 패키지 설치 단계가 자동으로 건너뛰어지며(skipped), 실제 비디오 디코딩 시 Triton 또는 eager 구현체로 자동 대체됩니다. 따라서 동일한 명령어로 크로스 플랫폼 설정이 가능합니다.
Hugging Face 인증 및 분할 모델 가중치 다운로드
LTX-2.5 모델 가중치는 총 용량이 약 66 GiB에 달하며 Hugging Face의 게이트(Gated) 저장소 형태로 관리됩니다. 모델 페이지에 접속해 이용 약관에 동의하지 않거나 유효하지 않은 자격 증명으로 접근하면 401 Unauthorized 또는 403 Forbidden 오류가 발생합니다.
안정적인 다운로드를 위해 먼저 다음 절차를 거쳐야 합니다.
- Hugging Face의 공식 LTX-2.5 저장소(Lightricks/LTX-2.5) 웹 페이지에 로그인한 후 약관 동의(Agree and Access)를 완료합니다.
- 계정 설정의 Access Tokens 메뉴에서 토큰을 생성합니다. 세부 권한(Fine-grained) 토큰을 생성할 경우 반드시 read gated repos 권한 스코프를 활성화해야 합니다.
- 터미널에서 자격 증명을 등록합니다.
hf auth login로그인을 완료한 후 공식 Hugging Face CLI(hf download)를 사용해 추론에 필수적인 safetensors 분할 가중치를 프로젝트 내부의 models/ltx-2.5 경로로 일괄 내려받습니다.
hf download Lightricks/LTX-2.5 \
    diffusion_models/ltx-2.5-22b-distilled-transformer-bf16.safetensors \
    text_encoders/gemma4-12b-with-proj-ltx-2.5-bf16.safetensors \
    vae/ltx-2.5-video-vae-bf16.safetensors \
    vae/ltx-2.5-audio-vae-bf16.safetensors \
    latent_upscale_models/ltx-2.5-latent-spatial-upscaler-x2-bf16-1.0.safetensors \
    --local-dir models/ltx-2.5
hf download 명령어에 --local-dir 옵션을 전달하면 원격 저장소의 하위 폴더 트리 구조(diffusion_models/, text_encoders/, vae/, latent_upscale_models/)를 유지한 채 로컬 디렉터리에 파일을 배치합니다. 따라서 후속 CLI 실행 시 상대 경로를 직관적으로 참조할 수 있습니다.
ltx_pipelines.distilled CLI를 활용한 첫 영상 생성 실습
가중치 배치가 완료되면 ltx_pipelines.distilled 모듈을 구동하여 텍스트 프롬프트 기반의 영상을 생성할 수 있습니다. 각 모델 컴포넌트의 로컬 파일 경로를 플래그로 지정해야 합니다.
uv run python -m ltx_pipelines.distilled \
    --transformer-path       models/ltx-2.5/diffusion_models/ltx-2.5-22b-distilled-transformer-bf16.safetensors \
    --text-encoder-path      models/ltx-2.5/text_encoders/gemma4-12b-with-proj-ltx-2.5-bf16.safetensors \
    --video-vae-path         models/ltx-2.5/vae/ltx-2.5-video-vae-bf16.safetensors \
    --audio-vae-path         models/ltx-2.5/vae/ltx-2.5-audio-vae-bf16.safetensors \
    --spatial-upsampler-path models/ltx-2.5/latent_upscale_models/ltx-2.5-latent-spatial-upscaler-x2-bf16-1.0.safetensors \
    --num-frames 121 \
    --seed 42 \
    --output-path output.mp4 \
    --prompt "A medium close-up shot features a Caucasian man with a beard, wearing a green and white baseball cap without any letters on the front, and a light blue shirt over a white t-shirt. He is positioned in the center of the frame, looking intently directly at the camera, his eyes focused on camera. His facial expression is one of deep concentration, with his brow slightly raised. As he looks straight at the camera, a quick sniff sound is heard, and then he speaks with a deep male voice and a satisfied tone, saying, 'I think it's so good.' The camera remains static throughout, maintaining a shallow depth of field, which keeps the man in sharp focus while the background is softly blurred, showing a beige wall behind him. After a brief pause, another short, audible sniff is heard. The man then continues to speak, his voice maintaining the same quality, as he states, 'So good. So good.' He elaborates further, emphasizing his point with a final statement, 'This got to be, it's got to be the best tool I've ever seen.'"
이 명령을 실행하는 단계와 점검 항목은 다음과 같습니다.
- 실행 단계: LTX-2 저장소 루트 디렉터리에서 위 명령을 입력합니다. uv 런타임이 격리된 환경 내에서 파이프라인 모듈을 초기화하고 지정된 각 가중치 파일을 메모리에 적재합니다.
- 정상 결과 확인: 텍스트 인코딩과 확산 샘플링, VAE 디코딩 및 공간 업스케일 연산이 완료되면 작업 디렉터리에 동기화된 음향이 포함된 비디오 파일인
output.mp4가 생성됩니다.--num-frames 121인자에 따라 121개 프레임 길이의 비디오가 기록됩니다. - 오류 점검 및 해결:
FileNotFoundError: 지정한 상대 경로가 실제 다운로드 위치와 일치하는지 확인합니다.models/ltx-2.5/하위에 각 하위 폴더가 누락되지 않았는지ls -R models/ltx-2.5명령으로 점검하세요.401/403 Client Error: 가중치 다운로드 단계에서 인증이 거부된 경우, Hugging Face 토큰 권한에 gated repos 읽기 권한이 부여되었는지 재확인하고hf auth login을 다시 수행해야 합니다.- OS별 빌드 오류: Windows나 macOS에서 natten 컴파일 실패 로그가 보일 경우, uv가 natten을 제외하고 Triton/eager 대체 백엔드로 전환했는지 확인하세요.